2025.04.28
ChatGPTのファインチューニングとは?仕組みと手順・費用を解説
ChatGPTを業務に活用する中で、プロンプトの工夫だけでは回答に限界を感じている方も多いのではないでしょうか。より業務や自社の目的に沿った回答を得られれば、生成AIの効果を最大限に引き出せ、自社の生産性はさらに向上します。
このようなニーズに応える手段として知られてきたのが、ファインチューニングです。既存のモデルに対して企業独自のデータで追加学習を行い、自社の業務に特化した振る舞いをさせる技術を指します。
ただし、2026年8月時点でOpenAIのファインチューニング基盤は新規ユーザーへの提供を終了し、段階的な縮小が進んでいます。仕組みを理解したうえで、自社が使える手段なのか、それとも別の方法を選ぶべきなのかを見極める必要があります。
この記事では、ファインチューニングの仕組みと手順、費用の構造、そして提供状況の変化と代替手段までを、公式ドキュメントの記載に沿って整理します。
目次
ChatGPTのファインチューニングとは?
ChatGPTのファインチューニングとは、学習済みのモデルに対して自社の業務や目的に沿った追加学習を行い、出力の形式や文体、判断の一貫性を目的に合わせて調整する手法です。OpenAIは、ファインチューニングを行う理由を「特定タスクでのモデル精度の向上」と「モデル効率の向上(同じ精度をより少ないトークン、あるいはより小さなモデルで実現すること)」の2つに整理しています。
出典:Optimizing LLM Accuracy | OpenAI API
つまりファインチューニングは、モデルに新しい事実を覚えさせるための技術というより、すでにできることを自社の型に合わせて安定させるための技術です。この前提を取り違えると、期待した効果が出ないまま費用だけがかさみます。
プロンプトエンジニアリングとの違い
プロンプトエンジニアリングは、モデルに与える指示や文脈を工夫して出力を改善する手法で、モデル自体には手を加えません。ファインチューニングは学習データを使ってモデルの重みを更新するため、毎回長い指示を書かなくても同じ振る舞いを再現できるようになります。
OpenAIは最適化の進め方として、まずプロンプトエンジニアリングで基準となる評価結果をつくり、そのうえで次の手を選ぶことを推奨しています。プロンプトの改善だけで十分な精度に届くケースも多く、いきなり学習に進む必要はありません。

なぜファインチューニングが注目されているのか
企業のAI活用が「汎用的に使えるか」から「自社の業務で毎回同じ品質が出るか」へ移るにつれ、出力のばらつきをどう抑えるかが課題になりました。ファインチューニングは、社内の表記ルールや回答フォーマットをモデル側に覚えさせることで、この一貫性の問題に直接手を打てる方法として注目を集めてきました。
もうひとつの理由がトークンの削減です。長い指示や例示をプロンプトに毎回積む代わりに学習で置き換えられれば、1回あたりの入力トークンが減り、呼び出し回数の多いシステムほど効果が大きくなります。
ファインチューニングの必要性については、以下の記事も合わせて参考にしてください。

ファインチューニングでできることとできないこと
ファインチューニングで解決できるのは、出力の形式が崩れる、文体やトーンが揃わない、指示に従いきれないといった振る舞いの一貫性に関する課題です。OpenAIはこれを「学習された記憶(learned memory)の問題」と呼び、正しく実行された例を数多く見せることで解決する対象と位置づけています。
一方、モデルが知らない情報を答えさせたい、社内の最新資料を根拠に回答させたいといった課題は「文脈(in-context)の問題」に分類され、プロンプトへの情報の埋め込みやRAGで解くべき領域とされています。ファインチューニングで社内文書を学習させれば知識が追加される、という理解は正確ではありません。
なお、ChatGPTの画面上で指示や参考ファイルを設定して専用アシスタントをつくるカスタムGPT(GPTs)は、モデルの重みを更新しない点でファインチューニングとは別の仕組みです。設定方法や活用例は下記の記事で扱っています。
OpenAIのファインチューニング提供状況(2026年8月時点)
OpenAIは自社のセルフサービス型ファインチューニング基盤の提供を段階的に縮小しており、2026年8月時点で新規ユーザーは利用できません。公式の料金ページには「OpenAI is winding down the fine-tuning platform. The platform is no longer accessible to new users」と明記されています。導入を検討する際は、まず自社が対象に含まれるかを確認するところから始める必要があります。
出典:Pricing | OpenAI API(2026年8月14日取得)
公表されている縮小スケジュール
OpenAIの廃止情報ページには、セルフサービス型ファインチューニングの提供に関する日付が段階的に示されています。過去にファインチューニングを実行した実績がない組織は、すでに新規のジョブ作成ができません。
| 日付 | 内容 |
|---|---|
| 2026年5月7日 | 過去にファインチューニングを実行したことがない組織は、ジョブ作成・学習を利用できない |
| 2026年7月2日 | 過去60日間にファインチューニング済みモデルで推論を実行していない組織は、ジョブ作成を利用できない |
| 2027年1月6日 | 継続利用中の既存顧客も、この日以降は新規のファインチューニングジョブを作成できない |
学習済みモデルはいつまで使えるか
すでに作成したファインチューニング済みモデルは、ベースとなったモデルが廃止されるまで推論に利用できるとされています。したがって、運用中のシステムがいつ止まるかは、使っているベースモデルの廃止日で決まります。
2026年8月時点で公表されている廃止予定は次のとおりです。ファインチューニング済みモデルは、接頭辞 ft- を付けた形で一覧に記載されています。
| 廃止日 | 対象のファインチューニング済みモデル | 推奨される移行先のベースモデル |
|---|---|---|
| 2026年10月23日 | ft-gpt-3.5-turbo | gpt-5.6-terra |
| 2026年10月23日 | ft-gpt-4 | gpt-5.6-sol |
| 2026年10月23日 | ft-gpt-4.1-nano-2025-04-14 | gpt-5.6-luna |
| 2026年10月23日 | ft-babbage-002 | gpt-5.6-terra |
| 2026年10月23日 | ft-davinci-002 | gpt-5.6-terra |
すでに運用している場合に取るべき対応
運用中のファインチューニング済みモデルがある場合、まず確認すべきはベースモデルの廃止日です。廃止日が近い場合は、移行先モデルでの再学習が可能な期間内に着手できるか、それとも学習を伴わない構成へ切り替えるかを、早い段階で判断する必要があります。
新規に検討していた企業にとっては、OpenAIのファインチューニングは選択肢から外れます。代わりに、プロンプトの設計とRAG、そして評価(Evals)の仕組みで同等の成果を狙う構成が現実的な出発点になります。次章でその使い分けを整理します。
ファインチューニング・RAG・プロンプトエンジニアリングの使い分け
3つの手法は上下関係ではなく、解く課題が異なる別々の手段です。OpenAIはこれらを「積み重ねられるもので、排他ではない(additive, not exclusive)」と説明し、直線的に順番を進めるものではないとしています。どれを選ぶかは、いま起きている不具合がどちらの軸の問題なのかで決まります。
出典:Optimizing LLM Accuracy | OpenAI API
「文脈の問題」か「振る舞いの問題」かで切り分ける
OpenAIは最適化を2つの軸で捉えることを勧めています。ひとつは、モデルが必要な知識を持っていない・情報が古い・社外秘の情報が必要といった場合に効く文脈の最適化です。もうひとつは、出力の形式が崩れる・トーンが揃わない・推論の手順が守られないといった場合に効くモデル側の最適化です。
| 症状 | 分類 | 主な打ち手 |
|---|---|---|
| 社内資料にしかない情報を答えられない | 文脈の問題 | RAG・プロンプトへの文脈付与 |
| 回答が古い情報のまま | 文脈の問題 | RAG |
| 出力フォーマットが毎回変わる | 振る舞いの問題 | ファインチューニング |
| 文体やトーンが指示どおりにならない | 振る舞いの問題 | ファインチューニング・DPO |
| 長い指示を毎回書く必要がありコストが高い | 効率の問題 | ファインチューニング |
RAGが向いているケース
RAGは、質問に応じて社内文書やデータベースから関連情報を取り出し、プロンプトに載せてから回答を生成する構成です。OpenAIは「ドメイン固有の文脈へのアクセスをモデルに与えるために使う」ものと説明し、自社の大規模な導入事例の多くがプロンプトエンジニアリングとRAGだけで実現されたとも記しています。
社内規程、商品マスタ、過去の問い合わせ履歴のように内容が更新され続ける情報を扱う場合は、RAGのほうが適しています。情報が変わったときにデータ側を差し替えるだけで済み、再学習が不要だからです。
ファインチューニングが向いているケース
ファインチューニングが効くのは、分類、決まった形式での生成、細かなニュアンスを伴う翻訳、指示に従いきれない場面の修正といったタスクです。いずれも「正解の形」がはっきりしていて、例を数多く見せることで再現性が上がる性質を持っています。
もうひとつの用途がトークンの節約です。毎回プロンプトに積んでいた例示やルールを学習側に移せば、同じ精度をより少ないトークンで実現できます。呼び出し回数が多いシステムほど、この効果が費用に直結します。
出典:Model optimization | OpenAI API
3つを組み合わせる進め方
OpenAIが例示している典型的な流れは、プロンプトを作って評価し、固定の例示を加え、次に検索の仕組みを足して例示を動的に取り出せるようにし、そのうえで50件以上のデータセットを用意して学習する、というものです。評価を挟みながら一段ずつ進める点が要になります。
順番を飛ばして最初から学習に取りかかると、そもそも何が問題だったのかが分からないまま費用と工数を投じることになります。まずは評価の物差しを用意することが、遠回りに見えて最短の道です。
ファインチューニングのメリットとデメリット
ファインチューニングには、汎用モデルでは対応しきれない自社特有の課題に踏み込めるという利点がある一方、データ準備や運用の負担という無視できない代償もあります。ここでは両面を整理します。提供状況の制約を踏まえたうえで、自社にとって投資に見合うかを判断する材料としてお読みください。
メリット
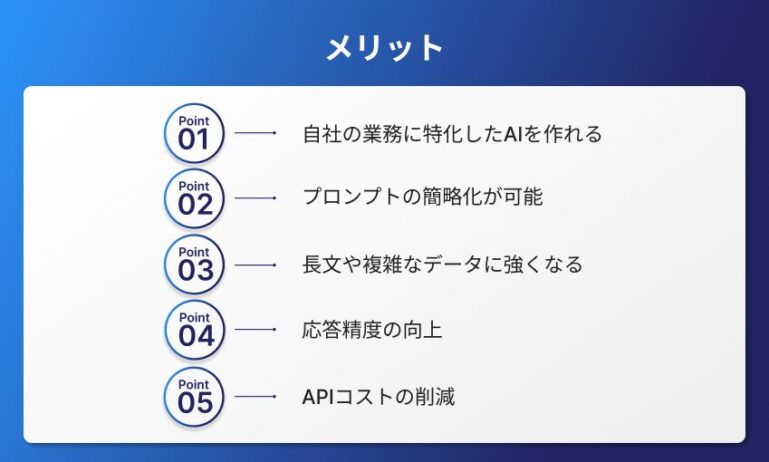
ファインチューニングは、汎用モデルでは揃えきれなかった出力の型を自社の基準に合わせられる手法です。ここでは具体的なメリットを解説します。
自社の業務に特化したAIを作れる
社内のFAQ、業務マニュアル、対応ログなどを学習させると、特定業種・職種の言い回しや判断基準に沿った応答を安定して返せるようになります。汎用モデルでは表現が揺れていた業界用語や社内ルールの扱いも、例を通じて一定の型に収められる点が利点です。
プロンプトの簡略化が可能
学習済みのモデルは前提となるルールをすでに保持しているため、複雑なプロンプトを組まなくても意図した出力を得やすくなります。「商品説明を書いて」といった短い指示でも学習した形式に沿った出力が返るので、AIに詳しくない担当者でも扱えるでしょう。
出力のばらつきを抑えられる
条件が複雑な業務や例外の多い判断でも、学習済みモデルであれば一貫した出力を返しやすくなるという効果があります。製造の工程管理や法務対応のように複数の要件を踏まえる場面では、担当者や日によって回答が変わらないこと自体が価値です。
応答精度の向上
企業固有の表現や回答パターンを学習しているため、似た質問に対して再現性の高い回答を返せます。チャットボットやヘルプデスクのような顧客サポート用途と相性がよく、応対品質の安定につながる領域といえるでしょう。
APIコストの削減
プロンプトが短くても高精度な応答が可能になるため、従来より少ないトークン数でやり取りが完結し、API利用料金の削減につながります。高頻度でAPIを呼び出すチャットボットや自動化システムでは、月単位で見たときの差が大きくなる点も見逃せません。
デメリット
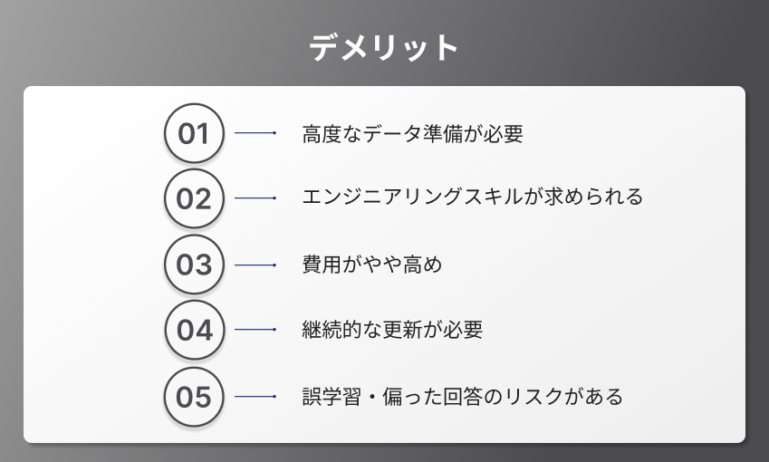
メリットの裏側には、準備と維持にかかる負担があります。導入の前に以下の点を把握しておきましょう。
高度なデータ準備が必要
ファインチューニングの精度は、与えるデータの質に大きく左右されます。社内ドキュメントをそのまま使うと誤った学習の原因になるため、不要な情報の削除、フォーマット統一、文体の調整といった前処理が欠かせません。OpenAIも、学習データの準備を「最も重要な工程」と位置づけています。
エンジニアリングスキルが求められる
モデルの学習やAPI設定には、コマンドラインやSDKの操作が必要です。データの構文エラーの切り分けや学習ログの確認、失敗時の対応にも一定の知識が要るため、実装フェーズではエンジニアを体制に組み込んでおくと安全です。
【e仕事エンジニア】エンジニア向けの求人メディア|日研トータルソーシング
費用が読みにくい
ファインチューニングは学習トークン量に応じた従量課金であるうえ、運用中も応答ごとに推論コストが発生します。プロジェクト単位ではなく運用全体での費用設計が必要になり、初期の見積もりだけでは判断を誤りやすい点に注意が必要です。
継続的な更新が必要
モデルは学習時点の情報に基づいて動作するため、社内ルールや商品仕様、法改正などの変更には自動では追随しません。定期的なデータ更新と再学習が前提になります。放置すると誤った案内を続けることになり、顧客対応の場面ではクレームにつながります。
誤学習・偏った回答のリスクがある
不適切なデータや偏った内容で学習すると、モデルはそれを正しい情報として扱います。特定部署の表現や一部の事例に偏ったデータで学習させると、全社利用のAIとしては不適切な応答を返す可能性があり、業務品質やブランドへの影響につながります。
社内ドキュメントの選定や前処理は、外から見えにくい割に成果を左右する工程です。malnaでは生成AI導入の初期段階から、どのデータを学習に使うべきかの整理を含めて支援しています。判断に迷う段階で構いませんので、お問い合わせからご相談ください。
ファインチューニングの具体的な手順
ファインチューニングは、学習データを用意し、ファイルをアップロードし、ジョブを作成し、結果を評価するという流れで進みます。ここではOpenAIの公式ドキュメントに記載されている手順に沿って説明します。前章のとおり新規ユーザーは利用できないため、以下は既存の利用環境がある場合、または他社基盤で同種の作業を行う場合の参考としてご覧ください。
必要な準備(APIキー、環境構築など)
まずOpenAIのアカウントを用意し、管理画面からAPIキーを発行します。続いて、APIを呼び出すための実行環境を整えましょう。公式ドキュメントではダッシュボードからの操作とAPI経由の操作の両方が案内されており、API経由の場合はcurlまたは公式SDKを使う形になります。
APIキーの取得の仕方
OpenAIのプラットフォームにアクセスし、APIキーの管理画面を開きます。
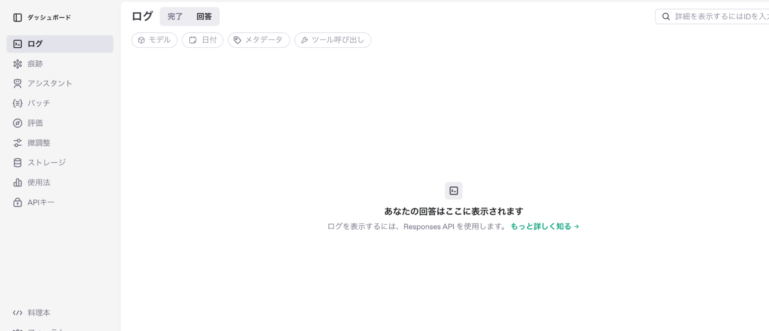
続いて、新しいシークレットキーを作成するボタンを押してください。

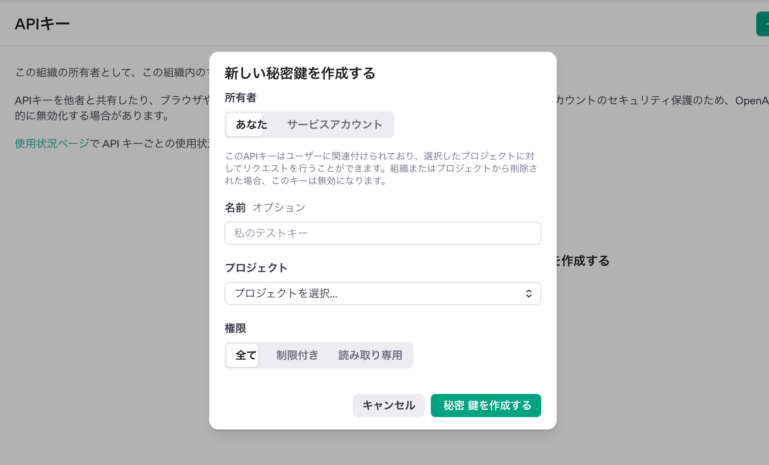
名前とプロジェクトを指定すればキーが発行され、その場でコピーできます。キーは再表示できないため、発行時に安全な場所へ保管しておきましょう。なお、APIキーは認証情報にあたるため、社内の資料やソースコードに直接書き込まない運用が前提です。
学習方式の選び方
OpenAIのプラットフォームで提供されている学習方式は4種類あり、解きたい課題によって使い分けます。対応するモデルも方式ごとに異なります。
| 方式 | 内容 | 向いている用途 | 対応モデル |
|---|---|---|---|
| 教師ありファインチューニング(SFT) | 正しい応答例を与えて振る舞いを導く | 分類、ニュアンスを伴う翻訳、特定フォーマットの生成、指示追従の修正 | gpt-4.1-2025-04-14 / gpt-4.1-mini-2025-04-14 / gpt-4.1-nano-2025-04-14 |
| ビジョンファインチューニング | 画像入力を含む教師あり学習 | 画像分類、複雑な指示への追従の修正 | gpt-4o-2024-08-06 |
| 直接選好最適化(DPO) | 正しい応答と誤った応答の両方を与え、どちらが正しいかを示す | 要点を押さえた要約、トーンや文体を揃えたチャット応答 | gpt-4.1-2025-04-14 / gpt-4.1-mini-2025-04-14 / gpt-4.1-nano-2025-04-14 |
| 強化ファインチューニング(RFT) | 応答に専門家が採点し、高評価の思考過程を強化する | 高度な推論を要する専門タスク(診断、法務文書の判断など) | o4-mini-2025-04-16(推論モデルのみ) |
出典:Model optimization | OpenAI API
一般的な業務利用でまず検討するのはSFTです。RFTは専門家による採点基準の合意が前提となるため、実施の難易度が大きく上がります。
データセットの構成と作成のポイント
学習データはJSONL形式で用意します。1行に1つの完全なJSON構造を書き、チャット形式(messages)で質問と応答の組を記述します。ファイルには最低10行が必要です。
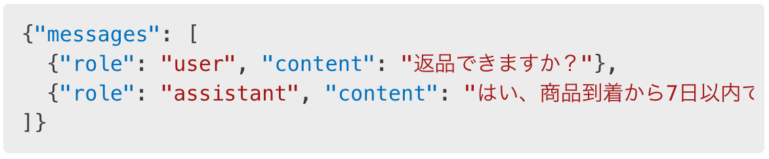
件数について、OpenAIは次のように案内しています。数千件を集めてから着手する必要はなく、少数でも質の高い例から始めて評価する進め方が推奨されています。
- 提供できる学習例の最小数は10件
- 50〜100件の学習で改善が見られるが、適切な件数はユースケースによって大きく異なる
- まずは丁寧に作った50件のデモンストレーションから始め、結果を評価することを推奨
出典:Supervised fine-tuning | OpenAI API
作成時は、実際のアプリケーションで想定される入出力にできるだけ近づけること、質問と回答を具体的かつ明確にすること、過去の実績データや専門家のデータを使うことがポイントになります。50件で効果が出るなら件数を増やし、50件で変化がないなら件数ではなく設計を見直す、という判断ができます。
学習~結果確認までの流れ
準備が整ったら、アップロード、ジョブ作成、進捗確認、テスト、本番適用の順に進みます。以下では各工程で使うAPIの呼び出し先と、確認すべきポイントを示しました。
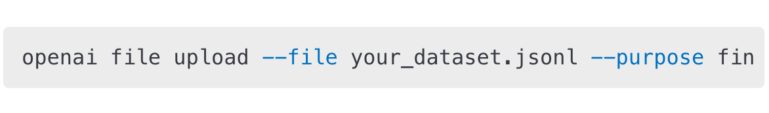
1. ファイルのアップロード
学習データを https://api.openai.com/v1/files にアップロードします。このとき purpose に指定する値は fine-tune です。レスポンスに含まれるファイルIDは次の工程で使うため、控えておいてください。
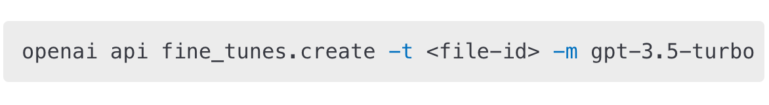
2. ファインチューニングの実行
https://api.openai.com/v1/fine_tuning/jobs にジョブ作成のリクエストを送ります。必須となるのは、アップロード済みファイルのIDを指定する training_file と、学習のベースにするモデルを指定する model の2つです。学習方式を切り替える場合は method を加えます。
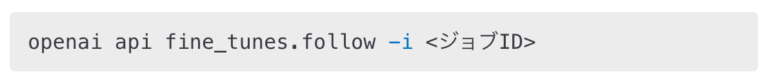
3. 学習の進捗確認(ログのモニタリング)
ジョブの状態はAPIまたはダッシュボードから確認できます。学習に要する時間は、データ量によって数分から数時間まで幅があります。
4. 完了後のモデル確認とテスト
ジョブが完了すると、レスポンスの fine_tuned_model にモデル名が入ります。名称は ft:gpt-4.1-nano-2025-04-14:組織名::識別子 のような形式です。この名前をモデル指定に使い、API経由で出力を検証します。
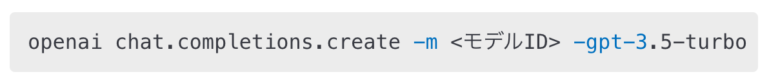
また、レスポンスの hyperparameters には実際に適用された n_epochs(学習の反復回数)、batch_size、learning_rate_multiplier が含まれ、trained_tokens で学習に使われたトークン数を確認できます。費用の実額はこの値をもとに把握できます。
出典:Supervised fine-tuning | OpenAI API
5. 本番運用
検証で問題がなければ、モデル名をチャットボットや社内システムに組み込みます。運用開始後も、学習前のモデルと比較する評価を定期的に回し、効果が出ているかを数字で確認する体制にしておくことが重要です。
業種別に見るAI活用事例とファインチューニングが効く場面
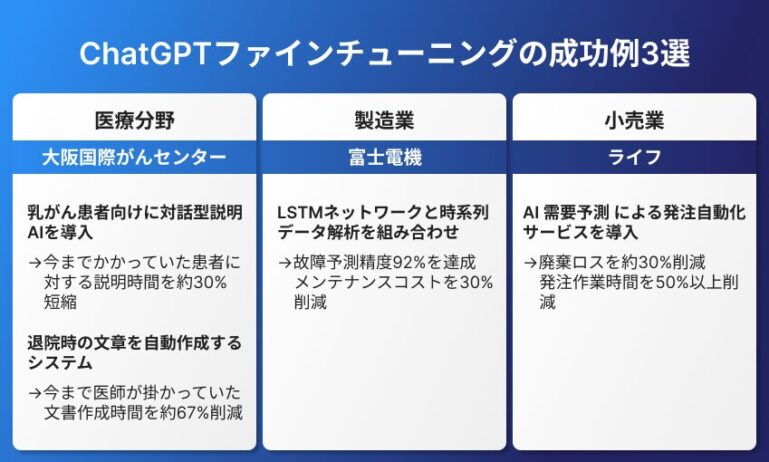
業務特化型のAI活用は、医療・製造・小売など幅広い業種で進んでいます。ここでは公表資料で内容を確認できる事例を3件取り上げます。いずれも公表資料の範囲ではモデルの学習方式まで明示されていないため、ファインチューニングの成果として断定はせず、業務のどこにAIを当てているかという観点でご覧ください。
医療分野 | 乳がん患者への疾患説明を生成AIが担う
日本IBM、医薬基盤・健康・栄養研究所、大阪府立病院機構 大阪国際がんセンターの3者は、AIアバターと生成AIチャットボットを組み合わせた「対話型疾患説明生成AI」を開発し、2024年8月から乳腺外来の初診患者を対象に実運用を開始しました。患者は受診前にPCやスマートフォンからアクセスし、疾患の説明を受けたり質問したりできます。
公表時点で約300種類の質問への回答に対応しているとされています。説明時間の削減率は、公開情報では示されていません。医療のように説明内容が定型化しやすく、かつ表現の正確さが求められる領域は、出力の型を揃える施策が効きやすい領域といえます。
出典:乳がん患者の質問に答える「生成AI対話システム」運用開始、大阪国際がんセンター | ASCII.jp
製造業 | 設備データからの異常兆候検知
富士電機は、化学製造業向けにAI技術を活用した設備診断システムを提供し、設備の運転データから異常兆候に関連性の高いデータ項目を絞り込んで検知する仕組みを導入事例として公開しています。異常兆候の発生時にアラームを発報する構成により、故障予知につなげています。
製造業の異常検知は、扱うデータが時系列の数値であり、対象も生成AIとは異なる機械学習モデルであることが一般的です。同じ「AIのモデルを自社データで学習させる」取り組みでも、ChatGPTのファインチューニングとは技術的な前提が異なる点は押さえておく必要があります。
出典:導入事例 AI技術を活用した設備診断システムによる異常兆候検知 | 富士電機
小売業 | 生鮮部門の発注をAI需要予測で自動化
BIPROGYは、ライフコーポレーションの全304店舗の生鮮部門にAI需要予測による発注自動化サービス「AI-Order Foresight」を適用し、2024年4月までに全店舗で稼働を開始したと発表しています。プロセスセンターおよびメーカー品への事前発注や発注確定時の数量調整に対応し、自動算出の期間を従来の5日間から3週間へ拡大しました。
発表資料では、欠品の減少による販売機会と廃棄ロスの削減を実現するとされていますが、削減率の具体的な数値は公表されていません。小売の需要予測も生成AIではなく予測モデルの領域であり、店舗ごとの条件に合わせてモデルを調整していく点に、自社データで精度を高める発想の共通性があります。
出典:ライフ全304店舗の生鮮部門に AI需要予測による発注自動化サービス「AI-Order Foresight」を適用 | BIPROGY
参考:生成AIのファインチューニング:産業応用の最前線 | 株式会社ProofX
ファインチューニングのコストと料金体系
ファインチューニングの費用は、学習にかかる料金と、運用中に発生し続ける推論の料金に分かれます。単価はモデルによって10倍以上の開きがあるため、どのモデルを選ぶかが総額を大きく左右します。単価は変更されることがあるため、実際の検討時は必ず公式の料金ページで最新の値をご確認ください。
モデル別の学習・推論単価
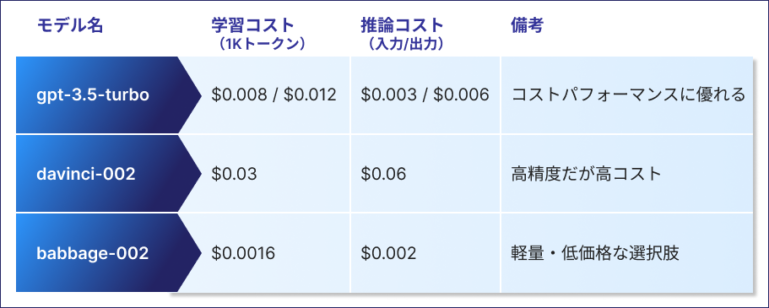
OpenAIの料金ページに掲載されているファインチューニングの単価は次のとおりです(2026年8月14日取得、100万トークンあたりの米ドル)。強化ファインチューニングに使うo4-miniのみ、学習が時間単位の課金になります。
| モデル | 学習 | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|---|
| gpt-4.1-2025-04-14 | $25.00 | $3.00 | $0.75 | $12.00 |
| gpt-4.1-mini-2025-04-14 | $5.00 | $0.80 | $0.20 | $3.20 |
| gpt-4.1-nano-2025-04-14 | $1.50 | $0.20 | $0.05 | $0.80 |
| gpt-4o-2024-08-06 | $25.00 | $3.75 | $1.875 | $15.00 |
| gpt-4o-mini-2024-07-18 | $3.00 | $0.30 | $0.15 | $1.20 |
| o4-mini-2025-04-16 | $100.00/時間 | $4.00 | $1.00 | $16.00 |
出典:Pricing | OpenAI API(2026年8月14日取得)
なお、料金ページにはgpt-3.5-turbo、davinci-002、babbage-002も掲載されていますが、いずれもレガシー扱いです。これらをベースにしたファインチューニング済みモデルは2026年10月23日に廃止が予定されているため、新たに選ぶ対象にはなりません。
バッチ処理を使う場合、学習単価は同じで推論単価がおおむね半分になります。即時性が求められない処理をまとめて流す設計にすれば、運用コストを抑えられます。
なお、ChatGPT本体の料金プラン(無料版・有料版の違いや選び方)は、APIの従量課金とは体系が異なります。プラン単位の費用を検討する場合は下記の記事をご覧ください。

学習・推論におけるトークンコストの仕組み
学習料金は、学習に使われたトークン数に対して課金されます。学習トークン数はおおむね「学習データのトークン数 × エポック数」で決まるため、同じデータでも反復回数が増えれば費用も比例して増えます。実際に課金対象となったトークン数は、ジョブ完了時のレスポンスの trained_tokens で確認できます。
推論料金は、入力と出力それぞれのトークン数に単価を掛けた金額です。上の表のとおり入力と出力で単価が異なり、出力のほうが高く設定されているため、長い回答を返す設計ほど運用費が膨らみます。
計算の例として、gpt-4.1-miniで100万トークン分の学習を1回行った場合、学習料金は$5.00です。同じデータをエポック数10で学習すれば学習トークンは1,000万トークン相当となり、$50.00になります。単価表と自社のデータ量があれば、この形で概算を出せます。
実際にかかる開発費・保守費の考え方
API利用料のほかに、実務では次のような費用が発生します。金額は自社実施か外注か、対象業務の複雑さによって大きく変わるため、公開情報から一律の相場を示すことはできません。見積もりを取る際は、以下の項目が含まれているかを確認してください。
- 学習データの収集・整形にかかる工数(既存文書の棚卸しと前処理を含む)
- 評価の設計と実施(学習前後を比較する物差しの作成)
- 検証段階での再学習にかかる追加のAPI利用料
- 運用開始後のAPI呼び出し費用(呼び出し回数×平均トークン数で試算する)
- 定期的なデータ更新と再学習の費用
この中で見落とされやすいのが評価の設計です。学習の前後で何がどう良くなったかを測れないままでは、追加投資の判断ができません。
費用対効果を高めるための工夫
費用対効果を高めるうえで重要なのは、対象業務を絞ることです。最初から全社的な自動化を狙うのではなく、問い合わせ対応や定型文の生成のように件数が多く成果が見えやすい領域から着手すると、投資判断がしやすくなります。
加えて、次の工夫が有効です。
- 高性能なモデルより、要件を満たす範囲で単価の低いモデルを選ぶ
- 学習データは量ではなく代表的なケースの質を優先する
- 出力トークンを抑える設計にする(冗長な前置きを返さない指示を組み込む)
- 即時性が不要な処理はバッチ処理に寄せて推論単価を下げる
- 更新はフルの再学習ではなく、変更点に絞った差分での対応を検討する
モデルごとの性能と単価の兼ね合いについては、下記の記事も参考になります。

導入前に知っておくべき注意点と失敗しやすいポイント
ファインチューニングの成否は、実装の巧拙よりも準備の質で決まります。あらかじめ失敗のパターンを把握しておくだけで、手戻りの多くは避けられます。ここでは、データ・体制・セキュリティの3つの観点から押さえるべき点を整理します。
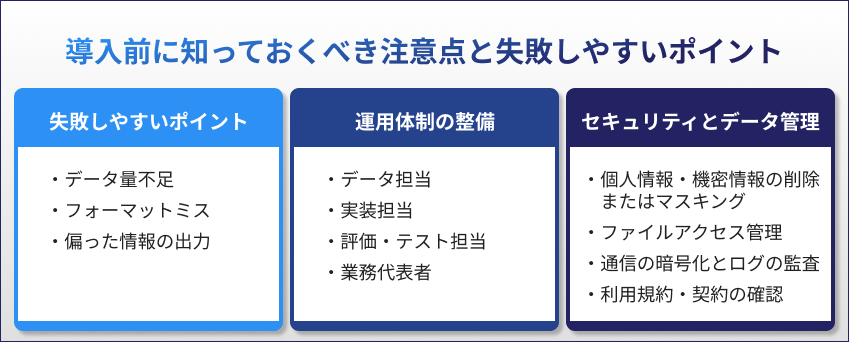
失敗しやすいポイント
準備や設計を誤ると、学習を行っても期待した効果が出ません。特に初めて取り組む段階でつまずきやすい3点を挙げます。
学習データの設計不足
件数を増やせば精度が上がる、という前提で進めると失敗します。OpenAIが推奨するのは、まず丁寧に作った50件で評価し、改善が見られるなら増やすという進め方です。50件で変化がない場合は、件数ではなく課題の切り分け自体を見直す必要があります。実際の利用場面と食い違う例をいくら足しても、精度は上がりません。
フォーマットミス
学習データはJSONL形式で正確に作成する必要があります。カンマの入れ忘れ、引用符の不統一、エスケープ文字の誤りといったエラーが1行でもあると、学習が中断されることがあります。表計算ソフトから手作業で書き出したデータはエラーが起きやすいため、投入前に構文チェックを挟んでください。
偏った情報の出力
学習データが一部の部門や文体に偏っていると、学習後のモデルはその偏りをそのまま再現します。特定部署の用語が強調されたデータだけで学習すると、他部署の利用者には使いづらいモデルになります。部門やユースケースごとにバランスを取ったデータセットを組むことが必要です。
チーム内での運用体制の整備
ファインチューニングは技術的な実装だけでなく、継続的な運用設計まで含めて成否が決まります。具体的には次のような役割分担が必要です。
- データ担当:社内文書や対応ログを収集し、整理・整形する
- 実装担当:APIを通じて学習ジョブの実行と設定を行う
- 評価担当:モデルの応答精度を定期的に確認し、再学習の要否を判断する
- 業務代表者:業務フローに合っているかを最終的に確認する
この分担でレビューのサイクルを組むことで、運用開始後も品質を保てます。とはいえ、誰をどこに配置するかで悩む担当者は少なくありません。malnaのAI導入支援では、技術的な実装だけでなく、こうした体制設計から評価の物差しづくりまで一貫して伴走します。お問い合わせからご相談ください。
セキュリティとデータ管理の注意点
学習に使うデータには、顧客情報、契約内容、機密事項が含まれる可能性があります。個人情報を含んだままアップロードすると、情報漏えいや社内規定違反のリスクを伴います。安全な運用のために、次の点に留意してください。
- 個人情報・機密情報の削除またはマスキング:氏名・住所・電話番号などは除外するか、置き換え表記に変換する
- ファイルアクセス管理:学習データの編集・閲覧権限は必要最小限に限定する
- APIキーの管理:認証情報はソースコードや共有ドキュメントに直接書かず、環境変数や秘密情報管理の仕組みで扱う
- 通信の暗号化とログの監査:API経由の通信はHTTPSを利用し、社内でもログの保存・監査体制を整備する
- 利用規約・データ利用ポリシーの確認:提供事業者のデータ取り扱い条件を事前に確認し、自社のコンプライアンスに適合しているかを検証する
個人情報保護法や業界ごとの法令が適用される場合は、法務部門と連携した進め方が必要です。取り扱いの可否については、社内規程と所管法令にもとづき専門部署の確認を取ってください。
ChatGPTのファインチューニングに関するよくある質問
ファインチューニングの検討では、提供状況や適用範囲、必要なデータ量といった論点で判断に迷う場面が多くあります。ここでは、実際に寄せられることの多い5つの質問を、OpenAIの公式ドキュメントの記載にもとづいて整理しました。社内での検討材料としてお使いください。
ChatGPTのファインチューニングは今も利用できますか?
2026年8月時点で、OpenAIのファインチューニング基盤は新規ユーザーには提供されていません。公式の料金ページに、基盤の縮小を進めており新規ユーザーはアクセスできない旨が記載されています。既存の利用者も、2027年1月6日以降は新規の学習ジョブを作成できないと公表されています。
ファインチューニングをすればChatGPTに社内の知識を覚えさせられますか?
知識の追加を目的とする用途には適していません。OpenAIは、モデルが知らない情報や最新の情報、社外秘の情報が必要な場合は文脈の最適化にあたる課題として、プロンプトへの情報付与やRAGで解くべきと整理しています。ファインチューニングが効くのは、出力形式やトーン、指示追従といった振る舞いの一貫性に関する課題です。
ファインチューニングには何件の学習データが必要ですか?
OpenAIの教師ありファインチューニングのドキュメントでは、提供できる最小数は10件、50〜100件で改善が見られる、まずは丁寧に作った50件から始めて評価することを推奨する、と案内されています。適切な件数はユースケースによって大きく異なるとも記載されています。
ファインチューニングとRAGはどちらを選ぶべきですか?
解きたい課題によって異なります。情報が足りない、古い、社外秘であるという課題ならRAG、出力の形式やトーンが揃わないという課題ならファインチューニングが対象です。OpenAIは両者を排他ではなく積み重ねられる手法と説明しており、併用も選択肢になります。
ファインチューニング済みモデルはいつまで使えますか?
ベースとなったモデルが廃止されるまで推論に利用できるとされています。2026年8月時点では、ft-gpt-3.5-turbo、ft-gpt-4、ft-gpt-4.1-nano-2025-04-14、ft-babbage-002、ft-davinci-002が2026年10月23日に廃止予定として公表されています。
まとめ
ChatGPTのファインチューニングは、出力の形式やトーンを自社の基準に合わせて安定させるための手法です。分類、定型フォーマットの生成、指示追従の改善といった振る舞いの課題に効く一方で、モデルに新しい知識を覚えさせる用途には向いていません。
そして2026年8月時点では、OpenAIのファインチューニング基盤は新規ユーザーへの提供を終了し、既存利用者にも2027年1月6日という区切りが示されています。これから自社専用の応答品質を目指すのであれば、評価の物差しを作り、プロンプトを設計し、必要に応じてRAGを組む構成が現実的な出発点になります。
重要なのは、いま起きている問題が「情報が足りない」のか「振る舞いが揃わない」のかを切り分けることです。ここを取り違えたまま手段を選ぶと、費用と工数だけが積み上がります。
malnaでは、生成AIの導入支援から社内運用体制の構築まで一貫したサポートを提供しています。どの手段が自社の課題に合うのかの切り分けから、評価設計、運用の定着までを伴走いたします。検討の初期段階からご相談いただけますので、お問い合わせよりお気軽にお声がけください。
AIを使える人材が社内にいない場合
手順はわかった。でも、これを担う人が社内にいないと感じた方もいるのではないでしょうか。
学習データの整形から評価の物差しづくり、再学習をいつ回すかの判断まで、実務でAIを扱ってきた人が一人いるかどうかで進み方は大きく変わるのではないでしょうか。malnaでは、AI活用の実務経験を持つ人材をご紹介するAIタレント名鑑を運営しています。採用ではなく業務委託として、週1日から相談いただけます。
執筆者情報
- writer malnaブログ編集部 webマーケター / データアナリスト
- Facebook・InstagramをはじめとするSNS広告からSEO対策など、マーケティングに関する様々な情報を発信しています。



関連記事タグをクリックでカテゴリページを開きます

- AIエージェント導入支援について
-
自社で50以上のAIエージェントを動かすmalnaが、貴社の業務に合わせてAIエージェントを導入します。
業務の棚卸し・診断は無料です。 - AIエージェント導入を相談する 詳しく見る