2026.09.21
Perplexity Sonarとは?料金とAgent APIへの移行を解説
社内から「Perplexityと同じことを自社のシステムでやりたい」という要望が出て、調べていくとSonarという名前に行き当たります。検索して出てくる解説を追えば、モデルの種類とトークン単価はすぐにつかめます。
目次
ところが公式ドキュメントを開くと、Sonarのほぼすべてのページの上部に、サポート期限は2026年9月27日だとして後継のAgent APIへ移るよう求める案内が表示されています。この期限はすでに過ぎていますが、終了した旨の告知は出ていません。モデルの種類や単価だけを見て契約を決めると、すぐに作り直しが必要になります。
本記事では、Perplexity Sonarの4つのモデルと料金の決まり方を整理し、そのうえでSonarのサポート期限(2026年9月27日)と、後継のAgent APIへの移行をどう進めるかまでを解説します。記載している仕様・単価・確認できた事実は2026年9月28日時点のものです。自社サービスにAI検索を組み込むかどうかを判断する立場にある、事業企画や情報システム、開発の責任者の方に向けた内容です。
どのAPIに乗せるかを決めきれず、検証だけが積み重なっている場合は、要件の整理からmalnaのAI導入支援でご相談いただけます。
Perplexity Sonarとは、Web検索の結果を根拠に回答を返すPerplexityのAPIです
Perplexity Sonarとは、Perplexityが提供するAPIのうち、リアルタイムのWeb検索の結果を根拠として回答文を生成し、参照したページの一覧をあわせて返す仕組みです。呼び出し先は api.perplexity.ai/v1/sonar で、リクエストの形はOpenAIのチャット補完に近い messages 配列、返り値は choices 配列という構造になっています。
Sonarという語は、このAPIそのものと、そこで指定するモデル群の両方を指して使われます。2026年8月13日時点で公式のモデル一覧に載っているのは4つで、検索向けの sonar と sonar-pro、推論向けの sonar-reasoning-pro、調査向けの sonar-deep-research です。
通常のLLM APIとの違いは、参照したページが構造化されて返ることです
Sonarと一般的な言語モデルのAPIを分けているのは、回答の生成と検索が1回のリクエストの中でつながっている点です。モデルに検索ツールを持たせて自分で組み立てる必要がなく、質問を投げれば検索が走ります。
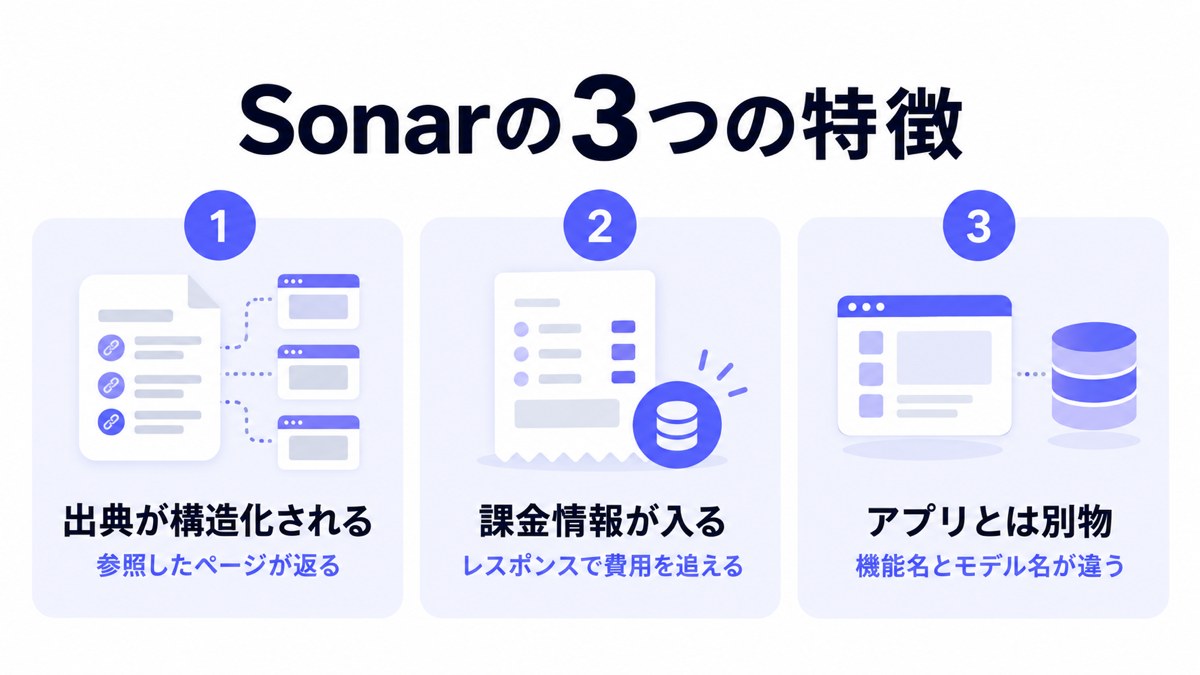
返り値の作りにも違いがあります。公式ドキュメントのサンプルレスポンスには、回答本文に加えて citations の配列と search_results の配列が入っています。後者には参照先のタイトル、URL、公開日を示す date、最終更新日を示す last_updated、抜粋の snippet が並びます。引用が文章の中の注釈ではなく、機械で処理できる形で返ってくるため、社内システム側で日付を見て古い情報を弾く、といった処理を後から足せます。
回答本文には [1] [2] のような番号が入り、citations の並び順と対応します。画面に出典を並べる処理は、この対応を使うだけで組めます。
課金の情報がレスポンスに入っている点も特徴です
Sonarのレスポンスには、そのリクエストにいくらかかったかが記録されています。usage の中に prompt_tokens と completion_tokens、検索コンテキストの大きさを示す search_context_size、そして cost として入力トークン費用、出力トークン費用、リクエスト費用、合計費用が入る形です。
実装段階でこの値をログに残しておくと、月末の請求書を待たずに1リクエストあたりの単価を追えます。表計算で見積もりを組むより、実際のレスポンスの値を集計するほうが確実です。想定より高かった場合の切り分けも、同じ値からできます。
Perplexityのアプリにある機能と、APIのモデル名は別物です
混同されやすいのが、Perplexityのアプリ上で提供されている機能と、APIのモデル名の関係です。アプリ側にもDeep Researchという名前の機能がありますが、APIの sonar-deep-research とは提供面が違います。片方はエンドユーザーが画面から使う機能、もう片方は開発者がコードから呼ぶモデルです。
さらに公式のFAQには、APIとUIで結果が違う理由として2点が挙げられています。同じ検索システムを使っているが設定が異なること、そして特定のクエリに対して裏で動くAIモデルがAPIとUIで異なる場合があることです。アプリで試した出力をそのまま実装後の品質見積もりに使うと、ずれます。
参考:Sonar API Quickstart(Perplexity 公式ドキュメント)
参考:Models(Perplexity 公式ドキュメント)
関連記事:生成AIとは?仕組みと活用事例・利用時の注意点をわかりやすく解説
Sonarのサポート期限は2026年9月27日で、Agent APIへの移行が必要です
Perplexityは2026年7月、Sonar Chat Completionsの後継としてAgent APIを位置づけ、既存の利用も新規のプロジェクトもAgent APIへ寄せるよう案内を始めました。現在、Sonarの各ドキュメントページの冒頭には、サポート期限を2026年9月27日とする警告が表示されており、料金ページやレート制限のページにも同じものが出ています。
サポート期限の2026年9月27日はすでに経過していますが、これから作る実装はAgent APIで始めることが前提になります。
移行の案内は各ページの冒頭に常時表示されています
警告の文面はどのページでも同じです。Sonar Chat CompletionsはAgent APIになったこと、サポート期限が2026年9月27日であること、移行ガイドの場所が書かれています。
この表示が出ているのは、Sonarのモデル一覧、各モデルの個別ページ、料金ページのSonarの節、レート制限のページ、Pro Searchの各ページです。
Sonarのサポート期限は2026年9月27日です
Perplexityの公式ドキュメントは、Sonarのサポート期限を2026年9月27日と告知しています。この期限は経過していますが、2026年9月28日時点で、Sonarのモデルページは引き続き公開されており、終了した旨の告知は出ていません。移行ガイドは、本番のワークロードにはAgent APIのほうが性能もコスト効率も優れているとしたうえで、推奨として次の2点を挙げています。
- 既存のSonar Chat Completionsの利用をAgent APIへ移行すること
- 新規のプロジェクトではAgent APIを使うこと
これから作る実装はAgent APIで始めてください。いまSonarで動いているシステムは、Agent APIへの切り替えを前提に動いてください。
変換表があるため、どのプリセットに置き換わるかは公式で確認できます
移行先の対応は表で示されています。Agent APIには処理の重さで分けられたプリセットが用意されており、Sonarの各モデルがどれに対応するかが明記されています。
| Sonarのモデル | 対応するAgent APIのプリセット | 想定される用途 |
|---|---|---|
| Sonar | fast | 単一の事実の確認、用語の定義、短い要約 |
| Sonar Pro | low | 日常的な調査、現在の情報を使う軽い多段階の照会 |
| Sonar Reasoning Pro | medium | 多段のブラウジング、多数の情報源からの広い集約 |
| Sonar Deep Research | high | 専門家レベルの推論と網羅的な情報源の確認 |
さらに上位として xhigh があり、公式が実施したベンチマークでは最も品質が高い構成だと書かれています。移行ガイドには、Sonarの messages と choices の組み合わせが、Agent APIでは input と型付きの output 配列に変わることも記載されています。呼び出し方は変わりますが、対応先が示されている分、見積もりは立てやすい部分です。
このAPIではモデルの削除が実際に行われてきました
移行の案内を軽く見ないほうがよい理由が、変更履歴に残っています。Perplexityは過去にも、提供していたモデルを変更履歴で告知したうえで削除してきました。対象になったのは他社製のモデルだけではなく、Sonarの系列に含まれていたモデルも1つ削除されています。
- 2025年8月1日にR1-1776を利用可能なモデルから削除
- 2025年12月15日に sonar-reasoning を非推奨とし、APIから削除
- 2026年3月20日に google/gemini-2.5-flash を削除し、4月1日に google/gemini-2.5-pro などが続いた
公式のFAQも、モデルが引退するときは変更履歴で代替候補とともに告知するとし、既定に頼らずリクエストでモデルIDを明示的に固定して変更履歴を見るよう勧めています。7月の変更履歴には、MCPサーバーの更新に関する記述の中でSonarのモデルを「legacy」と表現した箇所もありました。
参考:Migrate from Sonar to the Agent API(Perplexity 公式ドキュメント)
参考:How to migrate from Sonar(Perplexity 公式ドキュメント)
参考:Changelog(Perplexity 公式ドキュメント)
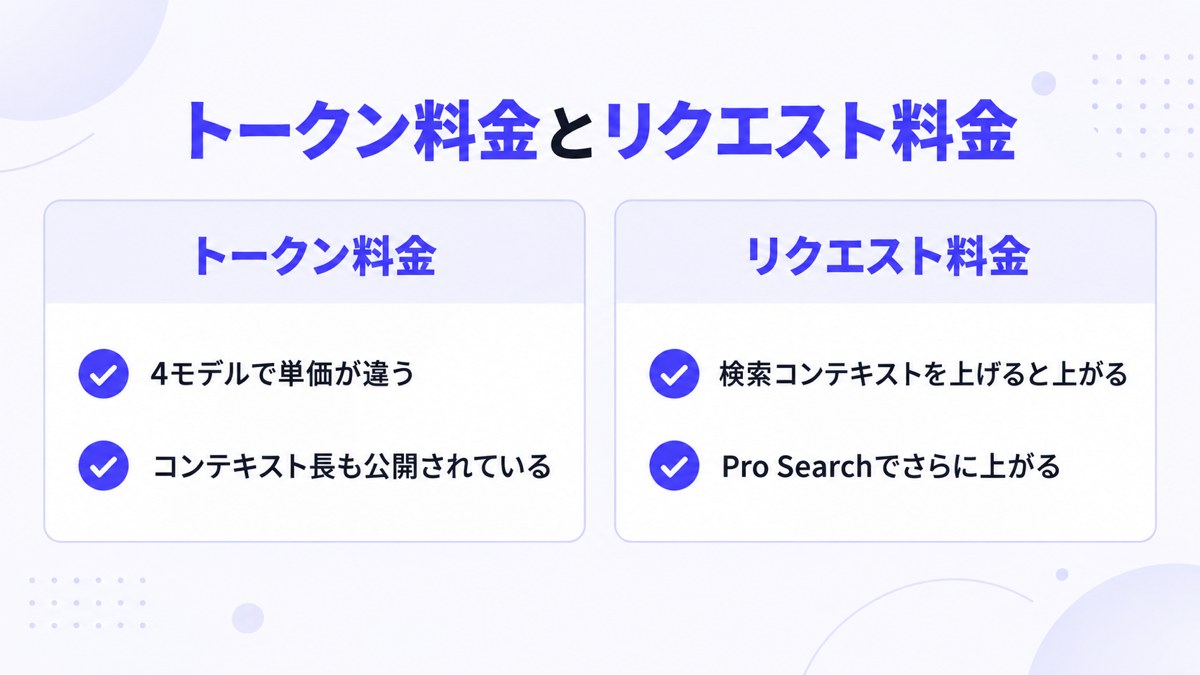
Sonarの料金は、トークン料金とリクエスト料金の2階建てです
Sonarの費用は、入出力のトークン量に応じた料金と、1リクエストごとに発生する料金を足したものになります。公式の料金ページは合計費用の考え方を、トークン費用にリクエスト手数料を加えたものと説明し、後者は検索コンテキストの大きさで変わるとしています。単価は2026年9月21日に料金ページで再確認した時点のもので、改定される可能性があります。
トークン単価だけを他社のAPIと並べると、実際の請求額とかけ離れます。Sonarの費用はリクエスト料金の側が支配的になりやすいため、比較のときは両方をそろえる必要があります。
4モデルの単価とコンテキスト長は公式ページで公開されています
各モデルの単価は、料金ページとモデルごとの個別ページの両方に掲載されています。リクエスト料金は1,000リクエストあたりの金額で、検索コンテキストの大きさに応じて3段階に分かれます。
| モデル | コンテキスト長 | 入力(100万トークン) | 出力(100万トークン) | リクエスト料金・低(1,000件) | 同・中 | 同・高 |
|---|---|---|---|---|---|---|
| sonar | 128K | 1ドル | 1ドル | 5ドル | 8ドル | 12ドル |
| sonar-pro | 200K | 3ドル | 15ドル | 6ドル | 10ドル | 14ドル |
| sonar-reasoning-pro | 128K | 2ドル | 8ドル | 6ドル | 10ドル | 14ドル |
| sonar-deep-research | 128K | 2ドル | 8ドル | 対象外 | 対象外 | 対象外 |
sonar と sonar-pro は推論を行わないモデルで、sonar-pro は標準のSonarに比べて検索結果を2倍返すと説明されています。sonar-reasoning-pro は思考の連鎖を使う推論モデルです。リクエスト料金は sonar-pro と sonar-reasoning-pro で同額のため、この2つの選択はトークン単価と用途で決まります。
Sonar Deep Researchだけ課金の項目が違います
sonar-deep-research にはリクエスト料金が設定されておらず、代わりに3つの項目が加算されます。数百の情報源を横断する処理のため、課金の単位も他の3モデルと別建てになっています。
| 課金項目 | 単価 |
|---|---|
| 引用トークン | 100万トークンあたり2ドル |
| 推論トークン | 100万トークンあたり3ドル |
| 検索クエリ | 1,000件あたり5ドル |
公式のFAQは、Deep Researchの推論トークンが回答内の思考の連鎖とは別のものだと説明しています。調査資料を読み解くために使われるトークンで、最終的な出力を作る段階の思考とは分けて数えられます。費用の見積もりを立てるとき、出力の長さだけでは足りない構造だという理解が要ります。
検索コンテキストを上げると単価も上がります
検索コンテキストの大きさは、web_search_options の中の search_context_size で指定します。既定は最も速く安い low で、費用と品質の釣り合いを取る medium、調査向けに検索の深度を最大にする high を選べます。設定の説明はいずれも公式ドキュメントに記載されています。
sonar の場合、1,000リクエストあたりの料金は low の5ドルから high の12ドルまで、2.4倍の幅があります。ここを既定のまま検証して本番で high に切り替えると、想定していた費用の枠を超えます。設定を変えたら試算もやり直す、という手順を運用に入れておくのが安全です。
Pro Searchを有効にするとリクエスト料金がさらに上がります
sonar-pro には、自動でツールを使い多段階の推論を行うPro Searchという動作があります。web_search_options の中の search_type で切り替え、有効にするには stream: true が必要だと公式に記載されています。
料金の差は小さくありません。既定の fast は1,000リクエストあたり6ドルから14ドルですが、pro を指定すると14ドルから22ドルになります。auto を選ぶと分類器がクエリの複雑さを見て自動で振り分ける仕組みで、複数の観点の比較が必要な質問はPro Search、単純な情報の取得はFast Searchに回ると説明されています。トークン単価は標準の sonar-pro と同じままです。
公式のサンプルでは、合計費用のほとんどがリクエスト料金でした
費用の内訳がわかりやすいのが、公式のモデルページに載っている sonar のサンプルです。入力9トークン、出力402トークン、検索コンテキストは low という条件で、合計費用は0.005420ドルと計算されています。
内訳を見ると、リクエスト料金が0.005ドルを占めています。入力と出力のトークン費用は合わせても0.0005ドルに届きません。短い質問と短い回答であれば、費用はほぼリクエスト数で決まるということです。月間の想定コール数が固まっていれば、トークン量の精度をそこまで詰めなくても概算は出せます。
参考:Pricing(Perplexity 公式ドキュメント)
参考:Sonar Pro(Perplexity 公式ドキュメント)
参考:Sonar Reasoning Pro(Perplexity 公式ドキュメント)
参考:Sonar Deep Research(Perplexity 公式ドキュメント)
参考:Pro Search Quickstart(Perplexity 公式ドキュメント)
関連記事:Gemini APIの料金は?モデル別の単価と無料枠、支払いの仕組みを解説
公式ベンチマークでは、Agent APIのプリセットがSonarの全モデルを上回っています
Perplexityは自社で実施したベンチマークの結果を公開しており、Agent APIのプリセットがSonarのどのモデルよりも高いスコアを出したと示しています。測定に使われたのは3つのベンチマークで、いずれも同じ作業負荷で比較したと書かれています。
数値の出どころが提供元自身である点は割り引いて読む必要があります。公式も、結果は用途によって変わるため自社のトラフィックで確認するよう添えています。それでも、移行を勧めている側がどの根拠で勧めているのかを把握しておく価値はあります。
測定に使われた3つのベンチマークの中身
使われたベンチマークは、多段階の検索を必要とする質問を扱うものが中心です。いずれも公開されている論文が出どころとして示されており、Perplexityが独自に作った尺度ではありません。それぞれ測っているものが違うため、1つの数字で優劣を見ないほうが実態に近くなります。
- BrowseCompは、多数の検索をつなぐ必要がある難しい質問に対するエージェント的なブラウジングの正答率を測る
- DSQA(DeepSearchQA)は、深い検索を要する質問への回答品質をF1で測る
- WideSearchは、構造化された結果をどれだけ網羅して埋められたかを行単位のF1で測る
3つ目のWideSearchは、表を埋める作業に近い評価です。項目の抜けが点数に直接出るため、一覧表の自動生成を考えている場合はここを見ます。
Sonarの4モデルとプリセットのスコアには大きな開きがあります
公式ページに掲載されている数値を並べると、同じ系列の中でも差がはっきり出ます。Sonarの4モデルは、軽量な sonar から調査向けの sonar-deep-research へ上がるにつれてスコアも上がりますが、上げ幅はベンチマークによって違います。まずSonarの4モデルの結果です。
| Sonarのモデル | BrowseComp | DSQA | WideSearch |
|---|---|---|---|
| Sonar | 7.00% | 27.26% | 8.01% |
| Sonar Pro | 7.33% | 30.11% | 17.92% |
| Sonar Reasoning Pro | 16.33% | 38.41% | 18.90% |
| Sonar Deep Research | 29.10% | 48.94% | 19.42% |
対応するAgent APIのプリセットは、次のような結果になっています。
| プリセット | BrowseComp | DSQA | WideSearch |
|---|---|---|---|
| fast | 28.00% | 60.99% | 32.78% |
| low | 54.18% | 78.92% | 45.69% |
| medium | 69.33% | 85.84% | 50.97% |
| high | 85.67% | 89.67% | 57.22% |
前掲の xhigh はこの表に載っていません。スコアと費用が公開されているのは上の4つだけです。
対応する組み合わせで見ると、すべての指標でプリセット側が上に出ています。Sonarの最上位であるDeep ResearchのBrowseCompが29.10%に対し、high は85.67%です。同じ系列の製品でここまで差が出ているという事実は、Sonarで作った実装をどれだけ長く維持する前提にするかの判断に直接効きます。
費用の面でも逆転している組み合わせがあります
ベンチマークのページには、スコアと合わせて1リクエストあたりの費用も掲載されています。精度が上がる分だけ費用も高くなるとは限らず、組み合わせによっては精度の高いほうが安く済んでいます。移行の判断で効いてくるのは、この逆転が起きている範囲がどこかという点です。
DSQAの結果では、high プリセットが89.67%を1リクエストあたり0.358987ドルで出しています。同じベンチマークのSonar Deep Researchは48.94%で0.5656ドルでした。精度が高いほうが単価も低いという並びです。移行ガイドの表にも、深い調査の階層では1リクエストあたりの費用がSonar Deep Researchより低くなることが多いと書かれています。
一方でWideSearchでは、high の0.883702ドルに対しSonar Deep Researchが0.5815ドルで、費用の関係が逆になります。スコアは high の57.22%に対しDeep Researchが19.42%ですから、精度を取るか単価を取るかの判断がここだけ発生します。どのベンチマークを見るかで結論が変わるため、自社の質問の形に近いものを選んで比べる必要があります。
Agent API側で増える機能は、費用の項目も増やします
Agent APIはモデルの選択肢とツールを増やす方向の設計になっています。移行ガイドの比較表では、Sonar側にあるのが組み込みのWeb検索、構造化出力、ストリーミング、非同期モードで、Agent API側にはこれに加えて外部の主要モデルの利用、人物検索、金融データの検索、コード実行のサンドボックス、MCPサーバーの接続、モデルのフォールバックが並びます。
増えた機能は課金の項目にも現れます。Agent APIではツールの呼び出しごとに料金が発生し、Web検索が1回0.0025ドル、URLの取得が0.0005ドル、人物検索と金融検索がそれぞれ0.005ドルと公開されています。Sonarのように1リクエスト単位で読める構造ではないため、移行のときは費用の数え方そのものを組み替えることになります。
参考:Agent API vs Sonar benchmarks(Perplexity 公式ドキュメント)
参考:Agent API Quickstart(Perplexity 公式ドキュメント)
関連記事:AIエージェントとは?主な種類と作り方・活用事例を解説
レート制限と請求は、累計のクレジット購入額と残高で決まります
Perplexityのレート制限は、これまでに購入したクレジットの累計額で決まる6段階の利用ティアに紐づきます。月々の支払額でも現在の残高でもなく、アカウントの生涯にわたる購入の合計で判定され、一度上がったティアは下がらないと明記されています。
この設計は稟議の順序に影響します。本番で必要な流量を先に確保するには、使う前にクレジットを買っておく必要が出てきます。検証してから予算を決める進め方とは、噛み合わない部分があります。
利用ティアは累計購入額で6段階に分かれます
ティアの条件は金額の形で公開されており、どの段階に入るかを自分で計算できます。基準になる金額はいずれも、これまでに購入したクレジットの合計です。当月の消費額ではないため、少額を毎月買い足す運用では段階が上がりにくくなります。
| ティア | 累計のクレジット購入額 | 公式の説明 |
|---|---|---|
| Tier 0 | 0ドル | 新規アカウント、限定的なアクセス |
| Tier 1 | 50ドル以上 | 軽い利用、基本的な制限 |
| Tier 2 | 250ドル以上 | 通常の利用 |
| Tier 3 | 500ドル以上 | 重い利用 |
| Tier 4 | 1,000ドル以上 | 本番の利用 |
| Tier 5 | 5,000ドル以上 | エンタープライズの利用 |
Tier 5を超える制限は専用のフォームから申請する仕組みです。ティアは支出のしきい値に達すると自動で上がり、新しい制限は即座に反映されると書かれています。
Deep Researchの1分あたりの上限は他モデルの数十分の一です
Sonarのレート制限は1分あたりのリクエスト数で示され、モデルごとに大きく違います。sonar-deep-research だけ桁が変わる点が、設計上の制約になります。
| ティア | sonar、sonar-pro、sonar-reasoning-pro | sonar-deep-research |
|---|---|---|
| Tier 0 | 50 | 5 |
| Tier 1 | 150 | 10 |
| Tier 2 | 500 | 20 |
| Tier 3 | 1,000 | 40 |
| Tier 4 | 4,000 | 60 |
| Tier 5 | 4,000 | 100 |
Tier 0では1分間に5リクエストしか通りません。非同期の投入エンドポイントである POST /v1/async/sonar も同じ数値です。深い調査を大量に走らせる設計は、最初のティアでは成立しないため、想定件数から必要なティアを逆算しておく必要があります。
制限の超過はリーキーバケット方式で判定されます
レート制限の実装は、バケットに溜まったトークンが一定の速さで漏れていくリーキーバケット方式です。上限に達すると429が返り、時間の経過とともに枠が回復します。瞬間的なバースト処理が通る点が、この方式の実務上の利点です。
1秒あたり50リクエストの制限であれば、満杯の状態から50件を一度に投げても通り、以降は20ミリ秒ごとに1件ずつ枠が戻ります。公式は、枠が余っているならリクエストを人為的に分散させる必要はないとし、指数バックオフとジッターの実装を勧めています。
残高が0になるとAPIキーが止まります
請求はクレジットの前払い方式です。API Portalと呼ばれる管理画面で組織単位のワークスペースを作り、支払い方法を登録してクレジットを購入する流れになります。決済はStripeが使われています。
運用で効いてくるのは残高の扱いです。公式は、クレジットを使い切るとクレジット残高を足すまでAPIキーがブロックされると明記しています。認証エラーの説明にも、401はキーが無効か削除されたか、あるいは残高が尽きたアカウントに属している場合に返るとあります。自動での補充を有効にしておけば止まらないとされていますが、設定を入れる担当と残高を見る担当を決めていないと、本番が止まる形の障害になります。
権限は管理者と一般メンバーの2種類です。管理者はメンバーの招待と削除、請求の管理、利用状況の閲覧ができ、メンバーは利用状況と上限の確認はできても設定の変更はできません。調達の面では、AWS Marketplace経由で請求をまとめる方法も案内されています。
キー単位のコストは請求書の末尾4桁で追う運用です
複数のキーを使い分けている場合、どのキーがいくら使ったかを見る方法も公開されています。管理画面の設定からダッシュボードを開き、請求履歴の請求書を選ぶと、明細の各項目の末尾に4文字のコードが付いています。この4文字がAPIキーの末尾4桁にあたります。
利用状況のグラフでは、チャット補完のリクエスト数、入力と出力のトークン、引用トークン、推論トークン、Deep ResearchとSearch API、Pro Searchのリクエスト数を切り替えて見られます。部門ごとにキーを分けて費用を配賦する運用は組めますが、専用の管理画面が用意される前の状態である点は押さえておく必要があります。公式のロードマップには、Perplexityのアプリとは独立した開発者向けのコンソールを構築中だと記載されています。
参考:Rate Limits & Usage Tiers(Perplexity 公式ドキュメント)
参考:API Groups & Billing(Perplexity 公式ドキュメント)
参考:AWS Marketplace(Perplexity 公式ドキュメント)
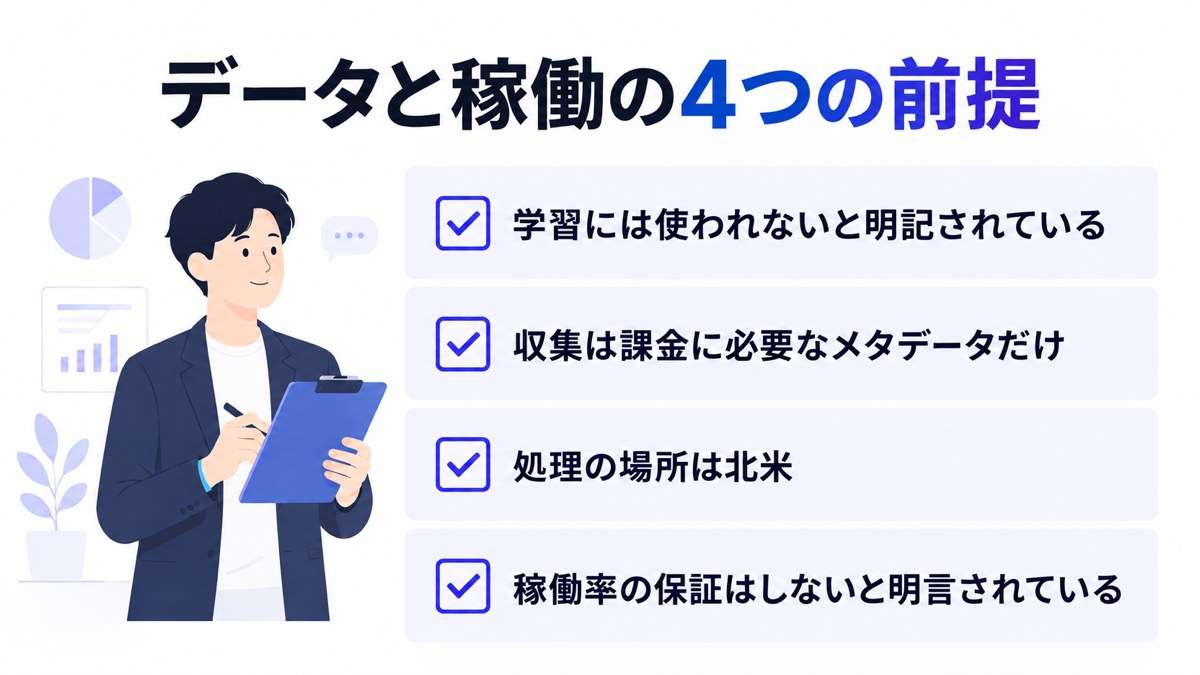
データは学習に使われませんが、置き場所は北米で稼働率の保証もありません
Perplexityは、Chat Completions APIについてデータを保持しないゼロデータ保持の方針を明記し、送られたデータをモデルの学習に使わないと書いています。一方で、処理を行う場所は北米のAWSであり、稼働率などのサービス品質については現時点で保証しないと公式のFAQに書かれています。
守られている項目とそうでない項目が、はっきり分かれている状態です。社内の審査に出すときは、この2つを分けて書いたほうが議論が進みます。
収集されるのは課金に必要なメタデータだけだと明記されています
プライバシーとセキュリティのページには、Chat Completions APIを通じて収集するデータの一覧が載っています。サービスの運用に必要な課金の指標に限られるという説明です。
- 処理されたトークン数
- 各リクエストで使われたモデル
- リクエストのタイムスタンプと処理時間
- 課金目的でのAPIキーの識別情報
同じページには、この課金のメタデータにはプロンプトや応答の内容、その他の利用者データが含まれないと書かれています。FAQ側にも、APIを通じて送られたクエリのデータは保持せず、利用者のデータで学習することはないという記述があります。既定でプロンプトデータの保持期間はゼロ日で、AIの学習には決して使わないとも書かれています。
認証取得の状況はTrust Centerで公開されているとされています
セキュリティの認証については、3つが挙げられています。セキュリティや可用性、機密性などを対象とする統制の監査であるSOC 2 Type IIのレポート、2025年のHIPAAギャップアセスメント、そしてクラウドのセキュリティ評価であるCAIQliteです。
いずれもPerplexityのTrust Centerから参照する形になっています。FAQには、データ処理契約やGDPRへの対応に必要な書類もそこから入手でき、そこに掲載されていない書類は問い合わせるよう案内されています。社内の審査で必要な書類が揃うかどうかは、契約前にこのTrust Centerで実際に確認するのが確実です。
処理の場所は北米のAWSです
データの置き場所は、FAQの中で一文だけ触れられています。Perplexityの言語モデルはどこでホストされているかという問いに対し、計算資源は北米のAWSを通じてホストされているという回答です。
公開されているドキュメントには、処理するリージョンを選ぶ設定や、日本国内で処理する選択肢の記載がありません。データを国内で処理することが要件なら、契約前に営業窓口へ直接確認してください。
稼働率の保証はしないと公式が明言しています
見落とされやすいのが、サービス品質の保証に関する記述です。FAQには、稼働時間や障害の頻度、障害時の復旧目標といった品質保証を提供しているかという問いが立てられており、回答は現時点では保証していないという一文だけです。
記載が見つからないのではなく、保証しないと書かれている状態です。業務の停止が許されない処理をこのAPIの応答に依存させる設計は、この一文と衝突します。障害時に人が引き取る手順を用意するか、複数の提供元を切り替えられる構成にするかを、実装の前に決めておく必要があります。障害の履歴とその時点の稼働状況は、システムステータスのページで確認する形です。
あわせて、ファインチューニングには現時点で対応していないことも明記されています。自社のデータでモデルを調整する前提の企画は、この時点で成り立ちません。
この種の項目は、技術検証の後回しにされやすいところです。動くことを確認したあとで法務や情報システムの確認に入り、そこで止まる流れになりがちです。契約前に確認する項目として先に洗い出しておくと、手戻りが減ります。
参考:Privacy & Security(Perplexity 公式ドキュメント)
業務で効くのは、出典が構造化されて返ることと検索範囲を絞れることです
Sonarを業務で使う理由になりやすいのは、回答の速さや精度よりも、根拠のURLと日付が機械で扱える形で返ってくることと、どこを検索させるかを指定できることです。この2つがそろうと、出てきた内容を人が確認する工程を仕組みに組み込めます。
この2点を使わない用途であれば、Web検索を伴わない一般的なモデルのAPIで足ります。選ぶ理由をここに置けるかが、判断の分かれ目です。
参照先を社内で決めたドメインに限定できます
検索の対象は search_domain_filter で制御します。ドメイン単位でもURL単位でも指定でき、最大20件まで登録できると公式に記載されています。
指定の仕方は2通りです。接頭辞を付けずに並べると、そのドメインだけを検索する許可リストとして働きます。ドメイン名の前にハイフンを付けると、そのドメインを除外する形になります。社内で信頼できると決めた情報源だけを検索させる構成が、パラメータ1つで作れるわけです。公的機関の公開情報だけを根拠にしたい業務では、この指定が効きます。
用途に特化したフィルタも用意されています。学術的な情報源に絞るフィルタと、SECの提出書類に絞るフィルタが公式ドキュメントに記載されており、後者は日付のフィルタと組み合わせて直近の提出書類を探す例が載っています。
返ってきた日付で情報の古さを判定できます
日付の扱いは2段構えになっています。リクエスト側では、公開日の範囲、最終更新日の範囲、そして直近のものだけを対象にする指定ができます。速報や進行中の出来事を扱う場合の指定として案内されています。
レスポンス側にも日付が入ります。search_results の各要素に date と last_updated が入るため、返ってきた結果を自社のシステム側でもう一度ふるいにかけられます。リクエスト時のフィルタとレスポンス時の判定を両方入れておくと、古い情報が最新のものとして扱われる事故を減らせます。言語のフィルタと地域のフィルタも同様に指定できます。
検索そのものを止める設定もあります
すべてのリクエストで検索が必要とは限りません。公式ドキュメントには、AIがいつ検索するかを判断する分類器を使う設定と、検索を完全に無効にする設定の両方が記載されています。
検索を止めればリクエスト料金の考え方も変わるため、費用の設計にも関わる設定です。加えて、APIでは既定でSafeSearchによるコンテンツフィルタが有効になっていると公式のFAQに書かれています。不適切な内容を検索結果から除く自動のフィルタです。
自社サイトの引用状況を調べる用途もありますが、範囲を決めて使います
Perplexity自体がAI検索のサービスであるため、Sonarを使って自社や自社の商品がどう説明されるかを定期的に取得する使い方も考えられます。指定したドメインだけを見に行かせる設定と、返ってきた search_results の記録を組み合わせれば、参照されたページの推移を残せます。
ただしこれは検索エンジン最適化の施策そのものではなく、状況を観測する仕組みの話です。何をどう改善するかは別の設計になるため、用途の一例として切り分けて考えるほうが混乱が少なくなります。
参考:Search Filters(Perplexity 公式ドキュメント)
参考:Frequently Asked Questions(Perplexity 公式ドキュメント)
競合や市場の情報を継続的に集める業務の考え方は、次の記事でも整理しています。
関連記事:競合調査のやり方!マーケターが確認すべき項目と手順を解説
他社のAPIと単価の構造を並べて比べたい場合は、次の記事も参考になります。
関連記事:Claude APIとは?使い方と導入手順・料金をわかりやすく解説
よくある質問
Perplexity Sonarについて残りやすい疑問を5つ整理しました。無料での利用、提供の継続、モデルの選び方、入力データの扱い、稼働保証の順に扱います。
Perplexity Sonarは無料で使えますか
公式ドキュメントに無料枠の記載はありません。請求はクレジットの前払い方式で、クレジットを使い切るとAPIキーがブロックされると明記されています。利用ティアの表ではTier 0が累計購入額0ドルで新規アカウント向けの限定的なアクセスと説明されており、この段階でも1分あたりのリクエスト数の上限は設定されています。
Sonarはいつまで使えますか
サポート期限は2026年9月27日です。Perplexityの公式ドキュメントは、Sonarの各ページの冒頭で、サポート期限を2026年9月27日と告知しています。2026年9月28日時点で、この期限は経過していますが、Sonarの各モデルページは引き続き公開されており、終了した旨の告知は出ていません。これから作る実装はAgent APIで始めてください。いまSonarで動いているシステムは、Agent APIへの切り替えを前提に動いてください。移行先のプリセットは、sonarがfast、sonar-proがlow、sonar-reasoning-proがmedium、sonar-deep-researchがhighです。
Sonar ProとSonar Reasoning Proはどちらを選べばよいですか
用途で分かれます。Sonar Proは推論を行わないモデルで、コンテキスト長は200Kで標準のSonarの2倍の検索結果を返すと説明されています。Sonar Reasoning Proは思考の連鎖を使う推論モデルで、コンテキスト長は128Kです。1,000リクエストあたりの料金は同額のため、トークン単価と処理内容で判断します。
Sonarに入力したデータは学習に使われますか
使われません。公式のプライバシーとセキュリティのページは、Chat Completions APIについてデータを保持せず、モデルの学習にも使わないと明記しています。収集されるのはトークン数、使用モデル、リクエストのタイムスタンプと処理時間、課金目的でのAPIキーの識別情報だけです。ただし処理は北米のAWSで行われると書かれています。
稼働率の保証はありますか
ありません。公式のFAQには、稼働時間や障害の頻度、復旧目標といった品質保証を提供しているかという問いに対し、現時点では保証していないと記載されています。業務が止まると困る処理に組み込む場合は、障害時に人が引き取る手順や、別の提供元へ切り替えられる構成を用意しておく必要があります。
まとめ
Perplexity Sonarとは、Web検索の結果を根拠に回答を生成し、参照したページを構造化した形で返すPerplexityのAPIです。4つのモデルが公開されており、費用はトークン料金とリクエスト料金の2階建てで、公式のサンプルでは短い質問と回答の場合に費用のほとんどをリクエスト料金が占めていました。
押さえておきたいのは3点です。Sonarのサポート期限は2026年9月27日で、公式ドキュメントが後継のAgent APIへの移行を求めていること(2026年9月28日時点で期限は経過していますが、終了した旨の告知は出ていません)。公式自身のベンチマークでは、対応するプリセットがすべての指標でSonarの各モデルを上回っており、深い調査の階層では単価が逆転する組み合わせもあること。そして、データは学習に使われず保持もされない一方で、処理の場所は北米で稼働率の保証はないと明記されていることです。
いまSonarを使っているなら、最初にやることは、稼働中のコードがSonarのどのモデルIDを呼んでいるかを確認することです。モデルIDが分かれば、移行ガイドの対応表で置き換え先のプリセットが決まります。そのうえで、Agent APIへの切り替えを前提に計画を立ててください。
AIを使える人材が社内にいない場合
選ぶ基準は見えた。でも、公式の推奨が変わるたびに追いかけて確かめる人が社内にいない。
移行の案内や単価の改定は公式ドキュメントに静かに載るだけなので、気づいた人が動いて初めて社内の判断に反映されるのではないでしょうか。malnaでは、AI活用の実務経験を持つ人材をご紹介するAIタレント名鑑を運営しています。採用ではなく業務委託として、週1日から相談いただけます。
読み終えてすぐ動かせるのはモデルIDの確認までで、その先の設計は要件を並べる作業になります。移行するかどうかを含めて整理したくなったら、malnaへお寄せください。
執筆者情報
- writer malnaブログ編集部 webマーケター / データアナリスト
- Facebook・InstagramをはじめとするSNS広告からSEO対策など、マーケティングに関する様々な情報を発信しています。



関連記事タグをクリックでカテゴリページを開きます

- AIエージェント導入支援について
-
自社で50以上のAIエージェントを動かすmalnaが、貴社の業務に合わせてAIエージェントを導入します。
業務の棚卸し・診断は無料です。 - AIエージェント導入を相談する 詳しく見る